ecspressoの設定ファイルにはJsonnetをお勧めします
こちらの記事へのアンサーです。(記事ありがとうございます!)
ecspresso init したときに生成されるデフォルトのファイル形式(タスク定義、サービス定義)は JSON + Go の text/template 関数形式なのですが、ecspresso はずいぶん前 (2021年の v1.7)から Jsonnet をネイティブに対応しています。また、v2.4からはテンプレート記法だけではなく Jsonnet native function というものが導入され、関数の記述がきれいに書けるようになっています。
以下のようなテンプレート記法の定義ファイルの記述箇所は
printfで組み立てる場合 スタック名の命名規則が <ベース名>-<環境> のように規則的であれば、printfでサフィックスを組み立てたほうが楽です。
ecs-task-def.json
"awslogs-group": "{{ cfn_output (printf `EcspressoDemoInfraStack-%s` (must_env `ENV`)) `LogGroupName` }}"
Jsonnet と native func を使うと以下のように、かなり読みやすく書けるようになっています。
local must_env = std.native('must_env');
local cfn_output = std.native('cfn_output');
local envName = must_env('ENV');

// ...
'awslogs-group': cfn_output('EcspressoDemoInfraStack-%s' % envName, 'LogGroupName'),
ほかにも Jsonnet を使うと、以下のように読みやすく書ける機能が豊富に使えます。お勧めです。
- コメントが書ける
- 変数定義ができる (text/templateでもできますが…)
- 他のファイルの include (
import) もできる - ecspresso が提供する関数の自然な呼び出し
- Jsonnet の標準関数 も自由に使える
ただし、Jsonnet で関数やimportなどを自由に駆使しすぎると、いざ出来上がった設定ファイルが後から読めない!ということにもなりがちです。
その場合は ecspresso render で JSON / Jsonnet としてプレーンな形式でレンダリングできるので、そこからリファクタリングをやり直すのがよいでしょう。ecspresso diff を使えば、リファクタリング後の定義ファイルが実際に差分を発生させないことも確認できるので、安心してやり直せますね。
ということで、ecspresso の設定/定義ファイルには Jsonnet を強くお勧めします、という作者からのお知らせでした。
まずは ecspresso init --jsonnet や ecspresso render --jsonnet でお試し下さい。
余談ですが、JSON + template 記法の小さな失敗と Jsonnet での解決へ至る道の経緯は以下の発表資料にあります。いろいろありますね。
ecspresso diffの差分表示にdyffを使って見やすくする
こんな記事が人気だったので便乗してみます。
ecspressoには現在のECS上の実リソースと構成ファイルの差分を表示する ecspresso diff というコマンドがあります。この差分表示はデフォルトでは unified 形式ですが、--external というオプションを使うことで任意の外部コマンドを差分表示に使用できます。
例えば、このような差分が表示されるとして
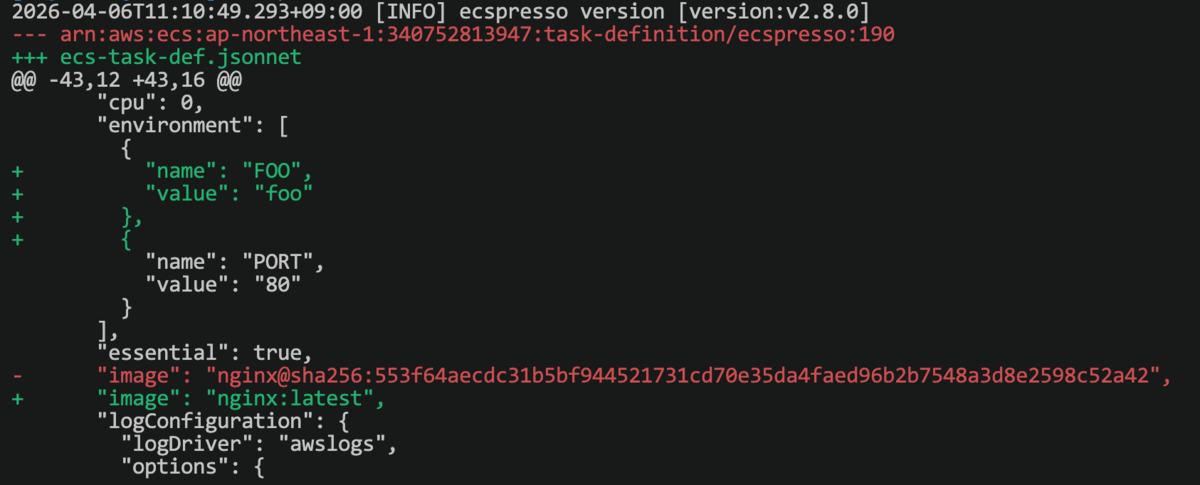
ecspresso diff --external 'dyff between -b' として dyff を使うとこのような表示になります。
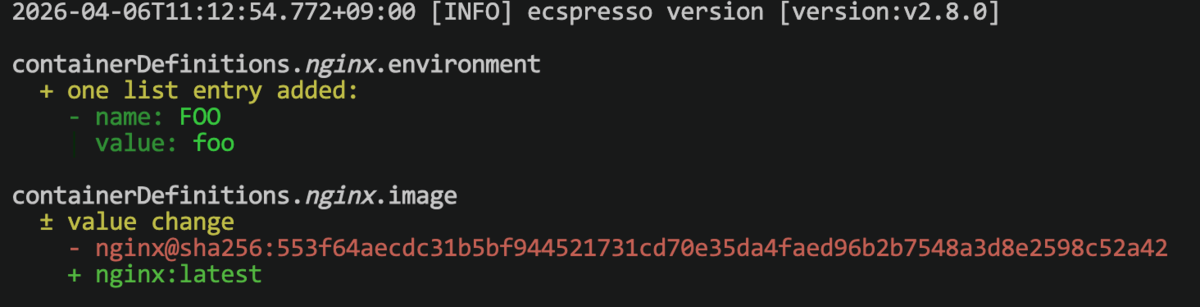
環境変数 ECSPRESSO_DIFF_COMMAND で設定もできるので、flagを毎回書きたくないときは export ECSPRESSO_DIFF_COMMAND="dyff between -b" としておけばよいですね。
dyff は Go 製のコマンド/ライブラリなので ecspresso 自体に組み込むこともできそうですが、とりあえずこのような方法もあります、という記事でした。
LLMエージェント対応を強化した ecspresso v2.8 をリリースしました
Amazon ECS デプロイツール、ecspresso v2.8.0 をリリースしましたのでお知らせです。
今回のリリースでは、LLMエージェントとの連携を強化する新機能、diff コマンドの機能拡充、サブコマンド体系の整理、バイナリサイズの削減などが含まれています。
注意事項
先に注意事項を2点お知らせします。
tasks / exec コマンドがサブコマンド形式に
tasks と exec コマンドは、従来のフラグ形式からサブコマンド形式に変更されました。
# 旧 (フラグ形式、非推奨)
$ ecspresso tasks --find
$ ecspresso tasks --stop

# 新 (サブコマンド形式)
$ ecspresso tasks find
$ ecspresso tasks stop
旧形式のフラグも引き続き動作しますが、非推奨の警告が出力されます。将来のリリースで削除される予定なので、早めの移行をお勧めします。
リリースバイナリからtfstate参照のためのGCS/Azure Blob Storageバックエンドを除去
リリースバイナリでは、Terraform state を参照するためのストレージとして GCS (Google Cloud Storage) と Azure Blob Storage のサポートが除去されました(fujiwara/tfstate-lookupによる機能)。これらのバックエンドが必要な場合は、no_gcs / no_azurerm ビルドタグなしでソースからビルドしてください。これによりバイナリサイズが削減されています。
新機能
docs サブコマンドを追加
ecspresso の README を直接参照できる docs サブコマンドが追加されました。ドキュメントは ecspresso のバイナリに直接埋め込まれており、他のファイルやネットワークアクセスがなくても単独で実行できます。
$ ecspresso docs                         # READMEを表示
$ ecspresso docs --list                  # 利用可能なドキュメント一覧を表示
$ ecspresso docs --search "jsonnet"      # 簡易的なキーワード検索
現時点で参照できるドキュメントは README のみですが、今後追加される可能性があります。
この機能の利点は、リリースバイナリに対応したバージョンの README が常に含まれることです。LLMエージェントが ecspresso について調べる際、Web検索や事前学習データに頼ると古い情報や不正確な情報を参照してしまうことがありますが、ecspresso docs を使えば、実際にインストールされているバージョンに正確に対応したドキュメントを参照できます。
skills サブコマンドの追加
LLMエージェントのスキルフレームワーク(Agent Skills)に対応した skills サブコマンドが追加されました。内部では Songmu/skillsmith を利用しています。
Agent Skills は、LLMエージェントに特定のドメイン知識やワークフローを教えるための仕組みで、SKILL.md というMarkdownファイルにメタデータと手順を記述する形式が標準化されつつあります。ecspresso skills は、ecspresso の一般的なワークフロー(デプロイ、diff確認、ロールバックなど)のコマンドパターンや、定義ファイルで Jsonnet を使う際のベストプラクティスなどをスキルとして提供します。
ecspresso skills install で ~/.agents/skills/ecspresso/SKILL.md がインストールされます。これをLLMに使わせることで、ecspresso を利用した設定などの扱いが上手くなってくれることを期待しています。
diff コマンドに --jsonnet フラグを追加
diff コマンドで --jsonnet フラグが利用できるようになりました。定義ファイルをJsonnet としてレンダリングした結果でのdiffを表示できます(ファイル形式自体はJSONでも問題ありません)。末尾カンマなどによる余計な差分が発生しにくくなります。
diff コマンドに --with-service / --without-service フラグを追加
diff コマンドで、サービス定義のdiffを含める/除外する制御ができるようになりました。タスク定義だけの差分を確認したい場合などに便利です。
バグ修正
- CodeDeploy を使用しているサービスで、
targetGroupArnの差分が誤って検出される問題を修正しました - 古い (stale) デプロイメントの完了を待ってしまう問題を修正しました
- デプロイ時にサービス属性の変更が発生すると、ECSサービスのデプロイメントが重複して実行される問題を修正しました
- 2.7 からのデフォルト
deploy --wait-until=deployedで正しく完了を待てない問題が修正されているはずです [Question] `healthCheckGracePeriodSeconds` as a workaround for deployment failure with `--wait-until="deployed"` (v2.7.0) · Issue #929 · kayac/ecspresso · GitHub
- 2.7 からのデフォルト
改善
- ログメッセージに構造化された slog attributes を使用するようになりました。ログの解析やフィルタリングがしやすくなっています
- 需要が少ない tfstate バックエンド (GCS, Azure Blob Storage) を無効にすることでバイナリサイズを削減しました
- もしこれがとても困る、という方がいたらお知らせください。戻すことを検討します。
- リリースビルドの Go バージョンを 1.26 に更新しました
まとめ
ecspresso v2.8.0 をリリースしました。LLMエージェントとの連携強化、diff コマンドの機能拡充、サブコマンド体系の整理、バイナリサイズの削減など、開発体験の改善を中心としたリリースになっています。どうぞご利用ください。
ECS Expressモードに対応した ecspresso v2.7 をリリースしました
Amazon ECS デプロイツール、ecspresso v2.7.0 をリリースしました。
新機能
ECS Express モードに対応
先日リリースされたAmazon ECSの新機能、Express モードに対応しています。
Amazon ECS Express Mode は、AWS 全体で一般的に使用されるリソースを作成するための新たな統合により、Amazon ECS サービスリソースへのシンプルなインターフェイスを提供します。ECS Express Mode は、ECS クラスター、タスク定義、Application Load Balancer、自動スケーリングポリシー、Amazon Route 53 ドメインを 1 つのエントリポイントから自動的にプロビジョニングして設定します。
簡単な定義で、ECSが動作するための周辺リソースを自動的に作成してくれるものですね。
ecspresso v2.7 では ECS Express モードに対して、従来の ecspresso が提供している機能をほぼ全面的にサポートしています。
ecspresso init --express: Express モードで動作しているサービスを定義ファイル化- 従来のタスク定義、サービス定義の代わりに
ecs-express-def.json(jsonnet)というExpress専用の定義ファイルを作成します。
- 従来のタスク定義、サービス定義の代わりに
ecspresso deploy: ExpressモードのECSサービスをデプロイ、作成ecspresso diff: 定義ファイルと実リソースのdiff形式差分表示ecspresso render [express-definition or expressdef]: 各種定義ファイルの JSON / Jsonnet 形式でのレンダリングecspresso delete: Express サービスの削除ecspresso status: Express サービスの状態表示ecspresso rollback: 実行中のデプロイに対してロールバックecspresso verify: Express 定義ファイル中のリソースに対しての検証exec,refresh,tasks,waitコマンド: 同様に動作します
もちろん、定義ファイルでのテンプレートやJsonnet関数での便利な機能(環境変数、tfstate、SSMパラメーターの参照など)も従来通り動作します。
ただし、以下のサブコマンドについては Express モードでは動作しません。
- scale, run, revisions, register, deregister, appspec
Expressモードのサービスに対して ecspresso status を実行すると、従来のstatusコマンドの表示に加えて、Express専用の状態(自動定義されたpublic endpointのDNS名など) も表示します。
$ ecspresso status
2025-11-23T11:38:42.750+09:00 [INFO] ecspresso version: v2.7.0
Service: printenv
Cluster: ecspresso
TaskDefinition: ecspresso-printenv:11
Express:
  Status: ACTIVE
  IngressPaths:
    PUBLIC pr-xxxxxxxxxxxxxxx.ecs.ap-northeast-1.on.aws
ちなみに、実際に動作する最小限の Express 用の定義ファイルは次のようなものです。ロールとコンテナイメージの定義だけ。簡単ですね! (IAM Roleだけは別途定義が必要ですが、これはマネージメントコンソールでも同様なのです)
{
  "executionRoleArn": "arn:aws:iam::123456789012:role/ecsTaskExecutionRole",
  "infrastructureRoleArn": "arn:aws:iam::123456789012:role/ecsInfrastructureRoleForExpressServices",
  "primaryContainer": {
    "image": "nginx:latest"
  }
}
Expressモードから通常のECSサービスへのマイグレーション
Expressモードは簡単に定義できるのですが、簡単さと引き換えにECSが持つ細かい機能へのアクセスができません。例えばタスク定義での詳細な設定 (ulimitとかfirelensを使ったログ送信とか) はExpress用の定義ファイルからは設定できません。
しかしecspressoは、このように簡単に定義されてデプロイされたExpress ECSサービスに対して、通常のサービス定義とタスク定義を作成する形にマイグレーションを行えます。ecspresso init --no-express を実行するだけです。
$ ecspresso init --service myservice --cluster default --no-express
これで従来の ecspresso 同様、ECSのフル機能にアクセスできるサービス定義(ecs-service-def)とタスク定義(ecs-task-def)ファイルが自動生成されます。あとは通常のECSサービス同様に設定を変更し、ecspresso deploy するだけです。
deployしてもECS上ではExpressモードのままですが、サービス定義とタスク定義の変更は通常のECSサービス同様に適用されます。
簡単操作で作ったはいいものの詳細な項目が弄れなくて困る、という心配はありません。
【制限事項】ExpressモードのECSサービスではサービス定義の deploymentConfiguration と loadBalancers は変更不可になっています。これらを操作したい場合は、生成された定義ファイルを使って別の(通常の)ECSサービスとしてdeployしてから変更することになります。
コンテナイメージを提供します
これまでのecspressoの配布方法に加えて、コンテナイメージの提供を始めました。
distrolessのベースイメージにecspressoのバイナリが入っているだけのものです。イメージは AMD64/Arm64 両対応です。
$ docker pull ghcr.io/kayac/ecspresso:v2.7.0
バイナリをインストールすることなく、dockerから~/.aws や定義ファイルが入っているディレクトリをvolume mountして実行することもできますし、独自のコンテナをビルドする際にマルチステージビルドで COPY --from=ecspresso /usr/local/bin/ecspresso などとしてecspressoのバイナリを取り込む用途にも使えます。
$ docker run --rm \
    -v ~/.aws:/root/.aws:ro \
    -v $(pwd):/work \
    -w /work \
    ghcr.io/kayac/ecspresso:v2.7.0 deploy --config ecspresso.yml
まとめ
- 2025年11月にリリースされたECSの新機能、Expressモードに対応した ecspresso v2.7.0 をリリースしました
- コンテナイメージの提供も始めました
- どうぞご利用ください
Prometheusで構築されたメトリック収集システムをMackerelに移行する
Mackerelアドベントカレンダー2025 10日目の記事です。
Mackerelのメトリックには3種類あります。昔からあるホストメトリックとサービスメトリック、そして2024年に正式リリースされた「ラベル付きメトリック」です。今回は、Prometheusで構築されているメトリクス収集の仕組みを、OpenTelemetry Collector と Mackerel を使って、監視対象はそのままに Mackerel のラベル付きメトリックとして収集するように移行する手法を紹介します。
Prometheus のメトリック収集方法のおさらい
Prometheus を使ったメトリック収集の仕組みを、大雑把に説明すると以下のようになります。
- 監視対象(daemonやアプリケーション)がHTTPでメトリックを出力するエンドポイントを公開する
- Prometheusは定期的に監視対象にHTTPでアクセスし、出力されているメトリックを収集して保存する
つまり、Prometheus 自身が監視対象からメトリックをクロールする、というアーキテクチャです。いわゆるPull型ですね。1
Mackerel は基本的に、監視対象(agentなど)がMackerelのサーバーに向けてメトリックを送信する、Push型のアーキテクチャを採用しています。
ということで元々 Prometheus 用に作られたメトリック収集システムを Mackerel に置き換えるには、「監視対象が export しているメトリックを誰かが収集した上で Mackerel に向かって送信する」仕組みを作る必要があります。
OpenTelemetry Collector で解決
「誰かが収集した上で Mackerel に向かって送信する」仕組みを自作する必要はありません。Mackerel のラベル付きメトリックには OpenTelemetry 互換のAPI endpoint が用意されているため、OpenTelemetry Collector (otelcol) から送信できます。otelcol で Prometheus用にexportされたメトリックを収集するのためには prometheus receiver が使えます。これらを組み合わせるだけです。
otelcol の設定例
早速ですが設定例です。
- prometheus receiver でメトリックを収集
- 例では
myserverというjob名でmyservers.jsonに定義された対象の/metricsから60秒ごとに収集する
- 例では
- batch processor で1分ごとに送信をまとめる
- 収集するメトリックが多い場合、1分ではMackerel側に一度に送信できるサイズを超えてしまうことがあります
- その場合は1分よりも短い間隔に設定する必要があります
- 今では、batch processor を使わないより良いまとめ送りができるかもしれません。詳しくは あなたのOpenTelemetry CollectorのBatch Processorはもう不要かもしれない - Diary of a Perpetual Student を参照してください
- resouce processor でメトリックに属性を追加
service.namespaceとしてmyservicedeployment.environment.nameとして環境変数 ENV の値を設定
- otlp exporter で Mackerel のラベル付きメトリックAPIエンドポイントに送信
receivers:
  prometheus:
    config:
      scrape_configs:
        - job_name: myserver
          scrape_interval: 60s
          metrics_path: /metrics
          file_sd_configs:
            - files:
                - /etc/otel-collector/file_sd_configs/myservers.json
processors:
  batch:
    timeout: 1m
  resource:
    attributes:
      - key: service.namespace
        value: myservice
        action: insert
      # https://opentelemetry.io/docs/specs/semconv/resource/deployment-environment/
      - key: deployment.environment.name
        value: ${ENV}
        action: insert

exporters:
  otlp/mackerel:
    endpoint: otlp.mackerelio.com:4317
    compression: gzip
    headers:
      Mackerel-Api-Key: ${MACKEREL_APIKEY}
  debug:
    verbosity: basic

service:
  pipelines:
    metrics:
      receivers: [prometheus]
      processors: [batch, resource]
      exporters: [otlp/mackerel]
この設定で otelcol を動作させておくことで、Prometheus 用に export されているメトリックをMackerelのラベル付きメトリックとして送信できます。簡単ですね!
小ネタ: 収集先ホスト一覧を mkr で用意する
収集対象のホスト一覧は、file_sd_configs を使って外部ファイルとして定義しています。こうすることで、otelcol を再起動せずに収集対象をメンテナンスできるようになります。
ファイル形式は以下のような JSON または YAML です。
[
  {
    "targets": [
      "192.168.0.1:9111",
      "192.168.0.2:9111",
      "192.168.0.3:9111"
    ]
  }
]
Mackerel でホストを管理している場合、mkr コマンドを使ってこのファイルを自動生成すると便利です。例えば以下のようにすると、Mackerel 上で定義されたホストのうち指定した条件のものでこの file_sd_config 用の定義を生成できます。
- サービス名: MyService
- ロール名: App
- ステータス: working のもの
- インターフェース名: eth0
$ mkr hosts \
   --service MyService \
   --status working --jq '[{"targets": [.[] | select(.roleFullnames | any(startswith("MyService:App"))) | .ipAddresses.eth0 + ":9111"] | sort}]'
定期的に実行しておけば、収集対象ホストの更新を完全に自動化できます。
小ネタ: Mackerel の「サービス」とOtelの「サービス」、概念の違い
Mackerel にも OpenTelemetry にも「サービス」という名前の概念があります。しかし少し残念なことに、この「サービス」が指す概念が異なっています。
- Mackerel のサービス: ある organization 内の独立した(例えばWebの)サービスを構築するホストをまとめたもの
- Otel のサービス: あるテレメトリ(メトリクス、ログ、トレース)を生成する論理的な単位 (アプリケーションやマイクロサービス、ミドルウェア)
- 例えば「nginx」や「MySQL」など
- Mackerel ではおおよそ、サービスの下の「ロール」に相当する概念
ということで、Otelcol が送信するメトリックの属性 service.name として相応しいのは、Mackerel の世界では「ロール」に相当します。Mackerel の世界の「サービス」を表す属性としては、Otel の世界では service.namespace を使うのがよいでしょう。
まとめ
この記事では、Prometheus で構築されたメトリック収集システムを、OpenTelemetry Collector を使うことで監視対象はそのままに Mackerel に移行する方法を紹介しました。
筆者の勤務するさくらインターネットのとある部署でも内部監視対象コンポーネントは主に Prometheus exporter で実装されていますが、この手法を利用することで Mackerel 上でのメトリック収集と監視を実現しています。
- Push型の Remote Write という仕組みもあります↩
SOPSで「さくらのクラウドKMS」を使う sops-sakura-kms を作りました
この記事は さくらインターネット Advent Calendar 2025 2日目の記事です。
3行でまとめ
- SOPS とさくらのクラウドKMSを組み合わせて使う sops-sakura-kms を開発しました
- sops コマンドのラッパーとして動作します。sops 自体は改変しません
- Terraform などとも連携できて便利です。どうぞご利用ください
サービス運用に使用するAPIキーやパスワードなど、いわゆる秘匿値をどう管理するかは悩ましいものです。1Password などのパスワード管理サービスや各種クラウドのシークレットマネージャーなどに保存するのが一般的ですが、バックアップや履歴管理のために、十分な強度を持った暗号化を施した上でリポジトリで管理したいことも多いと思います。
このような目的のために、自分はよく SOPS を使っていました。SOPS は元々 Mozilla が開発し、現在は CNCF (Cloud Native Computing Foundation) のサンドボックスプロジェクトとして管理されている暗号化ファイルエディタです。YAML や JSON などの設定ファイルの値を暗号化・復号化でき、AWS KMS、GCP KMS、Azure Key Vault、PGP、age など様々な鍵管理サービスと連携できます。
SOPS の嬉しいところは、YAML や JSON の構造やキーはそのまま、値だけを暗号化できることです。ファイル全体を暗号化してしまうよりも人間に優しい (= grep しやすい!) 状態で扱えます。
sops-sakura-kmsとは
sops-sakura-kms は、SOPS でさくらのクラウド KMS をデータキーの暗号化に使用できるようにするラッパーツールです。OSS として公開しています。
さくらのクラウド KMS について
さくらのクラウドは2025年に多数の新機能を追加しましたが、その中には KMS(Key Management Service) もあります。KMSはデータ暗号化に用いられる暗号鍵の作成、保管、削除などのライフサイクル管理を行うサービスで、FIPS 140-2 level 3 認証を受けた HSM (Hardware Security Module) と連携して暗号鍵を保護します。
KMS については、昨日12/1のアドベントカレンダーの記事もあわせてご覧ください。
せっかくさくらのクラウドでKMSが使えるようになったので、SOPSと組み合わせて使いたいと思ったのが開発のきっかけです。
SOPS に PR を送るべきか否か
SOPS は標準で AWS KMS、GCP KMS、Azure Key Vault、HashiCorp Vault などに対応していますが、さくらのクラウドKMSには対応していません。
最初は、SOPS に PRを送って対応してもらおうかと考えました。しかし既存の PR を調べたところ、Oracle Cloud (#1226)、Cloud.ru (#1718) など、各種クラウドのKMS対応を追加するPRはいくつも出ていましたが、これらは一向にマージされないようです。
メンテナーの気持ちになってみればそれはそうで、それほどメジャーでもない各クラウド固有の機能を見境なく取り込んでしまうと、のちのメンテナンスが大変になることは明らかです。
というわけでSOPS本体を変更しないアプローチを探したところ、いい感じに使えそうなアイデアが浮かんだので実装したのが sops-sakura-kms です。
動作の仕組み
sops-sakura-kms は、Hashicorp Vault Transit Engine 互換のHTTPサーバーとして動作します。
- sops-sakura-kmsを実行すると、ローカルで
127.0.0.1:8200にVault Transit Engine互換のHTTPサーバーを起動します - 環境変数
SOPS_VAULT_URIS、VAULT_ADDR、VAULT_TOKENを設定し、sopsコマンドを子プロセスとして実行します - 起動された
sopsコマンドはデータキーの暗号化、複合化のために127.0.0.1:8200に Vault Transit Engine API で通信します - サーバーはリクエストをさくらのクラウドKMS APIに中継し、実際の暗号化/復号化を行います
つまり SOPS から見ると「HashiCorp Vault」と通信しているように見えますが、実際にはさくらのクラウドKMSを使って暗号化・復号化が行われます。SOPSがすでに対応している Vault Transit Engine での暗号化機能に乗っかることで、SOPS本体を改変することなくさくらのクラウドKMSを利用できるようになりました。
インストール方法
sops-sakura-kms は複数の方法でインストールできます。
Homebrew
brew install fujiwara/tap/sops-sakura-kms
バイナリダウンロード
GitHubのリリースページ から、お使いの環境に合ったバイナリをダウンロードできます。
GitHub Actions
CI/CDパイプラインで使用する場合など、GitHub Actionsで簡単にセットアップできます。
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: fujiwara/sops-sakura-kms@main
        with:
          version: 'v0.1.0'  # または 'latest'
Dockerコンテナ
コンテナイメージも提供しています。このイメージには sops-sakura-kms と sops の両方が含まれています。
docker run --rm \
    -e SAKURACLOUD_ACCESS_TOKEN \
    -e SAKURACLOUD_ACCESS_TOKEN_SECRET \
    -e SAKURACLOUD_KMS_KEY_ID \
    -v $(pwd):/work -w /work \
    ghcr.io/fujiwara/sops-sakura-kms:v0.1.0 \
    -d secrets.enc.yaml
セットアップ
環境変数の設定
以下の環境変数を設定します。
# さくらのクラウドAPIクレデンシャル
export SAKURACLOUD_ACCESS_TOKEN="your-access-token"
export SAKURACLOUD_ACCESS_TOKEN_SECRET="your-access-token-secret"

# さくらのクラウドKMSのリソースID(12桁の数字)
export SAKURACLOUD_KMS_KEY_ID="123456789012"
KMSキーIDは、KMSキーを作成した後に確認できるリソースIDです。
オプションの環境変数
動作をカスタマイズするためのオプション環境変数も用意されています。
# サーバーのみモードで実行(SOPSを実行しない)
export SSK_SERVER_ONLY=true

# サーバーのリッスンアドレス(デフォルト: 127.0.0.1:8200)
export SSK_SERVER_ADDR="127.0.0.1:8200"

# 実行するコマンド(デフォルト: sops)
export SSK_COMMAND="/path/to/sops"
基本的な使い方
sops-sakura-kmsは、sops コマンドの単純な代替として使用できます。コマンドライン引数は加工せずに sops に渡すため、通常の sops コマンドと同じように使えます。
ファイルの暗号化
sops-sakura-kms -e secrets.yaml > secrets.enc.yaml
ファイルの復号化
sops-sakura-kms -d secrets.enc.yaml
暗号化ファイルの編集
sops-sakura-kms secrets.enc.yaml
これだけです!裏側で自動的にローカルサーバーが起動し、さくらのクラウドKMSと連携して暗号化・復号化が行われます。
応用的な使い方
サーバーのみを起動する
sops-sakura-kms は、SOPS を実行せずに Vault Transit Engine 互換サーバーとして単独で動作させることもできます。
export SSK_SERVER_ONLY=true
sops-sakura-kms
この状態で、Vault APIエンドポイントを直接呼び出せます。
# データの暗号化
curl -X PUT http://127.0.0.1:8200/v1/transit/encrypt/123456789012 \
  -H "Content-Type: application/json" \
  -d '{"plaintext":"aGVsbG8gd29ybGQ="}'

# データの復号化
curl -X PUT http://127.0.0.1:8200/v1/transit/decrypt/123456789012 \
  -H "Content-Type: application/json" \
  -d '{"ciphertext":"vault:v1:..."}'
このモードは以下のような場面で便利です。
Terraformとの連携
Terraform と sops-sakura-kms を組み合わせてシークレットを復号できます。まず、暗号化ファイルを作成します。
sops-sakura-kms -e secrets.yaml > secrets.enc.yaml
次に、Terraformでsops_fileデータソースを使用します。
terraform {
  required_providers {
    sops = {
      source  = "carlpett/sops"
      version = "~> 1.0"
    }
  }
}

data "sops_file" "secrets" {
  source_file = "secrets.enc.yaml"
}

output "secret_value" {
  value     = data.sops_file.secrets.data["password"]
  sensitive = true
}
Terraformの実行時はSSK_COMMAND環境変数を使って、sopsの代わりにterraformを実行するように設定します。
export SSK_COMMAND=terraform
sops-sakura-kms plan
sops-sakura-kms apply
これにより、sops-sakura-kms が自動的にVault Transit Engine互換サーバーを起動し、必要な環境変数を設定した上で terraform コマンドを実行します。Terraform 実行中に動作する sops プロバイダーはローカルサーバーを使ってシークレットを復号します。
まとめ
sops-sakura-kms は、さくらのクラウドKMSを SOPS で利用可能にするラッパーツールです。Vault Transit Engine 互換サーバーとして動作することで、SOPS 本体を改変することなく、既存のエコシステムをそのまま活用できます。
インストールも設定も簡単で、既存の SOPS ワークフローをほぼそのまま移行できます。GitHub Actions や Docker コンテナもサポートしているので、CI/CD パイプラインへの組み込みも容易です。
さくらのクラウドを利用している方、これから利用を検討している方は、ぜひ試してみてください! (ちなみにさくらインターネット社内でも、既に利用され始めています)
YAPC::Fukuoka 2025に参加して「Amazon ECS デプロイツール ecspresso の開発を支える「正しい抽象化」の探求」を発表しました
YAPC、楽しかったですね!
出していたプロポーザルが通ったので、発表もしてきました。
前回福岡で開催された YAPC::Fukuoka 2017 のちょっと後から自分が開発を始め、8年間機能追加とメンテナンスを続けている ecspresso という OSS について、以下のような内容をまとめたものです。
- ecspresso の設計と実装にはどのような思想があり、それは他の IaC ツールと比べてどうなのか
- IaC ソフトウェアにとっての抽象化、その選択はツールの使い勝手やメンテナンスコストにどう影響するのか
満員の会場で聞いてくださった方からもご好評をいただけたようで、よかったです。
「勝ちに不思議の勝ちあり、負けに不思議の負けなし」私の好きな言葉です。
なおタイムテーブル上 mizzy さんの「なぜインフラコードのモジュール化は難しいのか - アプリケーションコードとの本質的な違いから考える」と連続する枠になっていて、これとセットで聞くととても良い流れになっていました。運営のみなさまありがとうございます。
Day 0 - 8年ぶりの福岡
前回 2017 年の YAPC 以来の福岡でした。皆いう事ですが空港が近くて楽ですね!到着後、日没前に走りに行きました。
大濠公園はランニングコースと景色が素晴らしく、滞在中一回しか走れなかったのが残念なくらいいい所でした。西公園、PayPayドーム、百道浜へと夕暮れを見ながら走って16kmほど。
19時からは「さくらの夕べ」(自社イベント)に参加して皆さんと話したりちょっとトークしたり。
その後P山さんはじめお馴染みの? 面子で飲んでいた人たちの2次会に混ぜてもらって楽しく飲みました。
Day 1
朝からC会場でトークを聴き、自分の発表が終わったところで 941 さんからこれから収録するので来て、と呼ばれたので「ほっとテック」に初参加したり…
#ほっとテック 更新しました!YAPC::Fukuoka 現地の様子をお届けします。ゲストは @inao @kis @higuhey @ogijun @fujiwara の皆さんです。
— 🍵🦾ほっとテック公式 (@hottotech) 2025年11月15日
#341 YAPC::Fukuoka 現地ゲスト特別回 Day1 #yapcjapanhttps://t.co/I3jDzbaJsC
Day 1 終了後は前職(カヤック)の同僚のご実家の居酒屋でOB会的な飲み会、うまいものと酒が無限に出てきたので飲みすぎました。
Day 2
朝、電車を乗り損ねてちょっと遅刻してinaoさんのトークを途中から。あの件の真相(というか事実)を聞いてなるほどーとなりました。その後はずっと「踊り場」会場にいて、inaoさんのトーク感想会、onkさんのDay 1最速振り返りとかmoznionの「OSS開発者なら学生参加者いっぱい集められるはず」という謎企画で OSS 作者座談会的なのをしたり。学生さんがいっぱい来てくれてよかった。 YAPC は同窓会と言われることも多いですが、毎回新しい参加者も増えていていいですよね。
カケハシさんのコーヒーも会期中大変お世話になりました。美味しかったです。
最後のP山さんキーノート、大変よかったです。飛び込んでいく勇気は大事ですね。ところで途中で二つほどあった「決まり手」、聞いていたときは何が決まり手なのかいまいち分からなかったんですが、もしかしてそれが無かったらペパボさんに入ることもなく、違う人生になっていたのかも?という意味での決まり手だったのかな、と後から思いました。
懇親会は毎回2時間じゃ足りないなと思いつつあっという間に過ぎ、Findy さんの Drinkup でビールをご馳走になりました(毎回ありがとうございます)。
#yapcjapan 懇親会! pic.twitter.com/Z7d8XjVsks
— fujiwara (@fujiwara) 2025年11月15日
帰宅 … 前に IT 駅伝を走る
いつもであれば最終日のあとは観光などをしてゆっくり帰るのですが、今回は NIPPON IT チャリティ駅伝に会社の人たちと出走することになっていたので8時の飛行機で福岡空港→羽田空港→お台場、と移動… (YAPCのことを完全に忘れて申し込んでしまった)
3日間連続で酒を飲み睡眠が足りない状態では当然タイムは出ず、去年の自己ベストより50秒以上遅いという醜態を晒したので来年は万全で臨みたいと思います。
なお、さくらインターネットAチームは他のチームメンバーの活躍により総合19位(612チーム中)でした。すごい!

ということで blog を書いたので今年の私の YAPC もこれで完了です。
来年は 2015 年に最大規模で開催された YAPC::Asia と同じ東京ビッグサイトに凱旋、ということで今から楽しみですね。
参加された皆様、スタッフの皆様、スポンサーの皆様、会場提供していただいた福岡工業大学の皆様、本当にありがとうございました。楽しかったです!
